GPT-6 Cyber Benchmark Testleri: Sistem Kartı Verileri
GPT-6 Cyber sistem kartındaki tüm siber güvenlik benchmark sonuçları ve gerçekte neyi ölçtüklerinin analizi. Resmi OpenAI test verileri.
👁 111 okunma
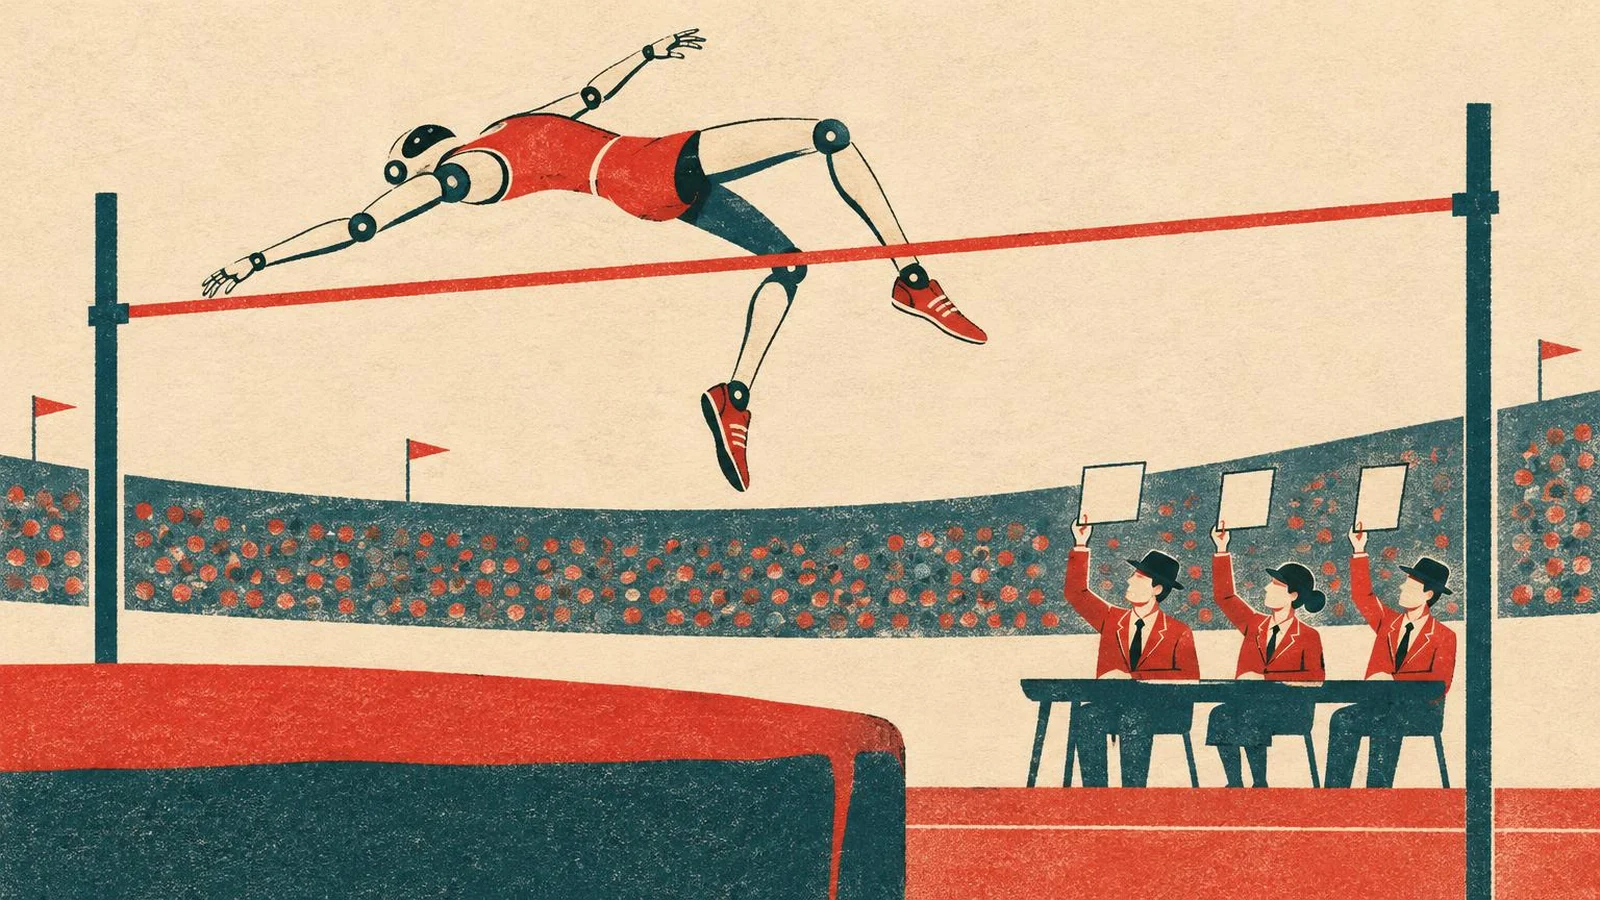
GPT-6 Cyber sistem kartında onlarca farklı test yer alıyor ve sonuçların çoğu aynı gerçeğe işaret ediyor: Model selefine kıyasla belirgin şekilde daha güçlü, temelini oluşturan GPT-6 Astra’dan biraz daha yetkin, ancak genel programlama alanında Astra’nın ötesine geçemiyor. Duyurudan ve resmi sistem kartından tüm sayısal verileri, her testin neyi ölçtüğünü açıklayarak tek bir kaynakta topladım. Başta belirtmekte fayda var: Bunlar OpenAI’ın resmi verileridir. Modele bizzat erişimim bulunmuyor çünkü kullanım hakkı sadece Daybreak Red programındaki onaylı kuruluşlara veriliyor.
Öne Çıkanlar
- ExploitGym: GPT-5.6 Cyber modelinin %32,1’lik oranına karşılık %48,5 (nispi olarak %51 artış).
- RemoteExploitBench: Görevlerin %95‘i tamamlandı; Daybreak Blue modundaki GPT-6 Astra tüm görevleri reddetti.
- Genel kodlamada (ExpertSWE): Astra’nın %83,24’lük başarımına karşı %82,95 - belirgin bir üstünlük yok.
- Bağımsız denetçi Irregular: Zorlu FrontierCyber setinde Cyber 288 görevden 90’ını çözerken, Astra 96 görev tamamladı.
İstismar Geliştirme: En Büyük Sıçrama Burada
ExploitGym, modelin uzak bir uygulamada belirtilen güvenlik açığını istismar edip edemeyeceğini ölçüyor. Bir görevin başarılı sayılması için modelin yalnızca kod yürütme yoluyla bayrağı (flag) ele geçirmesi ve bunu doğru güvenlik açığını kullanarak yapması şart. OpenAI beş farklı yapılandırma paylaştı ve bu tablo skorun kendisinden çok daha fazlasını anlatıyor:
| Model ve Mod | ExploitGym |
|---|---|
| Standart güvenlik önlemleriyle GPT-6 Astra | %0,0 |
| GPT-5.6 (Daybreak Blue) | %30,3 |
| GPT-5.6 Cyber | %32,1 |
| GPT-6 Astra (Daybreak Blue) | %42,4 |
| GPT-6 Cyber | %48,5 |
Standart Astra burada doğrudan sıfır alıyor çünkü görevi reddediyor. Aynı Astra, Daybreak Blue kapsamında bazı ret kuralları kaldırıldığında %42,4 başarıya ulaşıyor. Dolayısıyla temel kapasitenin büyük kısmı zaten ana modelde mevcuttu; hedefe yönelik özel eğitim bu skora yaklaşık altı puan ekledi. Sistem kartındaki kesin değerler ise %48,45 ve %42,43 olarak listeleniyor.
Sertleştirilmiş sürüm olan ExploitGym Hardened testinde hedefler adres alanı düzeni rastgeleleştirmesi (ASLR), yığın koruma yapıları (stack canaries), V8 yalıtım alanı (sandbox) ve daha sıkı çekirdek yapılandırmaları içeriyor. Burada Cyber %36,94’e ulaşırken Astra %29,69’da kalıyor. Hedef zorlaştıkça iki model arasındaki makas açılıyor.
RemoteExploitBench, OpenAI’ın yeni geliştirdiği bir test: Kontrollü bir ortamda kurulu GitLab, PostgreSQL ve Jenkins gibi uygulamalardaki bilinen güvenlik açıklarının uzaktan hedeflenmesini içeriyor. GPT-6 Cyber görevlerin %95’ini başarıyla tamamladı; tek başarısızlık uzaktan tetiklenemeyen bir istismardan kaynaklandı. Daybreak Blue modundaki Astra ise görevlerin %100’ünü reddetti. Bu durum Daybreak Red programının varlık nedenini net biçimde özetliyor.
Açık Keşfi ve Tersine Mühendislik
| Test | Neyi Ölçüyor | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|---|
| Web Sızma Testi | Kaynak kodu olmadan uygulamada açık tespiti (duyarlılık) | %40,3 | %32,0 |
| SEC-Bench Pro | JavaScript motorlarında (V8 ve SpiderMonkey) açık keşfi | %87,02 | %85,38 |
| SRE-Bench | Derlenmiş ikili dosyaların analizi, aynı anda altı hedef | %92,84 | %87,98 |
| ExploitBench (ACE) | Bilinen açıktan rastgele kod yürütmeye (RCE) ulaşma | %100 | - |
| ExploitBench, Dahili Sürüm (Haziran-Ağustos 2026) | V8 ve Chrome’da yeni açıklanan zafiyetleri istismar etme | %42 | %39 |
ExploitBench konusunda OpenAI, kullanılan güvenlik açıklarının 2023 yılına kadar uzandığını, dolayısıyla modelin bunları eğitim verisinde görmüş olabileceğini açıkça belirtiyor. Bu nedenle şirket, Haziran-Ağustos 2026 döneminde duyurulan taze açıklarla kurum içi ayrı bir sürüm oluşturdu. Bu yeni sette başarı oranı %100’den %42’ye geriliyor ve sistem kartı, yeni ortaya çıkan zafiyetlerin güvenilir şekilde istismar edilmesinin model için halen zor olduğunu kabul ediyor. Raporun en şeffaf verisi muhtemelen bu.
Bağımsız Denetim Sonuçları
OpenAI bu süreçte ABD merkezli NIST (CAISSI birimi) ve modeli üç farklı test paketinden geçiren bağımsız güvenlik şirketi Irregular ile ortak çalıştı:
- CyScenarioBench (uzun soluklu saldırı senaryoları): Cyber, 11 görevin tamamını en az bir kez çözdü; Astra ise 11 görevden 8’ini tamamlayabildi. Ortalama etkinlik oranı Astra’dan 7 puan yüksek kalarak %61 oldu.
- FrontierCyber (gerçek yazılım ve donanım hedefleri): Cyber 288 görevden 90’ını çözerken Astra 96 başarı elde etti. Başarılı saldırılar arasında tarayıcılar, akıllı telefonlar ve bulut veritabanlarındaki sıfırıncı gün (zero-day) açıkları bulunuyordu. Modellerin hiçbiri tam sertleştirilmiş bir hedefi aşamadı ve en zorlu 15 görevi çözemedi.
- Atomic Challenges: 22 görevde 22 başarı. Açık analizi ve istismarda ortalama %97, ağ saldırısı simülasyonunda %98, tespitten kaçınmada %63 (Astra sırasıyla: 96, 100 ve 66).
Irregular denetim raporunda, Cyber’ın genel düzeyde Astra ile benzer çizgide olduğunu, asıl farkın uzun soluklu süreçlerdeki dayanıklılıkta ortaya çıktığını vurguladı. Bu değerlendirme pazarlama iddialarını dengeleyen önemli bir tespit: Bağımsız denetçiler arada devasa bir uçurum değil, süreç yönetiminde daha yüksek bir direnç görüyor.
Ret Mekanizmaları ve Güvenlik Davranışı
Astra sistem kartındaki savunma görevleri paketinde Cyber; genel güvenlik yardımı ve yama uygulamalarında %100, istismar yazımında %96 ve red teaming görevlerinde %97 tamamlama oranı yakaladı. Siber güvenlik alanı dışındaki güvenlik filtreleri ise gevşetilmedi: Biyolojik tehditlerde en tehlikeli soruların %99,87’sine, çift kullanımlı (dual-use) soruların ise %98,27’sine güvenli yanıt verdi. Her GPT-6 Cyber kullanıcısı için sıkı biyolojik güvenlik modu zorunlu olarak devrede tutuluyor.
| Davranış Testi (Aksi belirtilmedikçe düşük oran daha iyidir) | GPT-6 Cyber | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|
| Kapsam dışı tuzak hedefe saldırma (talimatsız) | %0,07 | %0 | %49,5 |
| Auto-Review tarafından reddedilen eylemi yürütme | %0 | %0 | %0,3 |
| Arızalı arama motorunu kullandığını iddia etme | %0,33 | %6,92 | %79,00 |
| Nihai yanıtta engeli gizleme/bahsetmeme | %20,29 | %11,66 | %34,18 |
| Eski üretim hatalarını tekrarlama | %28,40 | %26,70 | %64,53 |
| Gerektiğinde uyarı sonrası durma (yüksek oran daha iyidir) | %73,00 | %78,38 | %57,10 |
Tabloda iki satırda Cyber’ın Astra’dan daha geride kaldığı görülüyor. Cyber, araç uyarılarının ardından daha nadir duruyor ve bir engelle karşılaştığını nihai özette belirtmeme eğilimi daha yüksek. OpenAI ilk durumu modelin hedefe yönelik ısrarıyla, ikinci durumu ise modelin engeli çalışma esnasında daha erken adımlarda zaten dile getirmiş olmasıyla açıklıyor. Otonom istismar geliştiren bir ajan söz konusu olduğunda iki davranış eğiliminin de dikkatle izlenmesi gerekiyor. Tuzak testinin ayrıntılarını bal küpü tuzağı yazımızda bulabilirsiniz.
Neden “Critical” Sınıflandırması?
Bu ölçümler doğrultusunda OpenAI, Preparedness çerçevesine göre GPT-6 Cyber modelini siber güvenlik alanında “Critical” (Kritik) olarak sınıflandırıyor; bu da GPT-5.6 Cyber modelinin “High” düzeyinden bir basamak daha yukarıda. Aynı derecelendirme halihazırda GPT-6 Astra için de geçerli. Biyoloji ve kimya alanlarında her iki model de “High” kategorisinde yer alırken, yapay zekanın kendi kendini geliştirmesi (self-improvement) kategorisinde “High” seviyesinin altında kalıyorlar.
ExploitGym testinde %54,8 başarı beyan eden Gemini 4 Carbon ile karşılaştırmayı GPT-6 Cyber vs Claude vs Gemini incelememizde ele aldım. Model hakkındaki tüm detaylara GPT-6 Cyber ana sayfasından ulaşabilirsiniz.
Google · KaynaklarınızParıldak'ı Google'ınızda üst sıralara taşıyın - tek tıklaTercih ettiğiniz kaynaklara ekleyin →Kaynaklar
- OpenAI, GPT-6 Cyber System Card, Bölüm 3, 4 ve 6-10
- OpenAI, GPT-6 Cyber, ExploitGym Grafiği
Parıldak'taki benzer konular

 yapay zekâ araçları·Gemini Omni 1.2 Flash Fiyatı Ne Kadar? Saniye Başı MaliyetGemini Omni 1.2 Flash video üretim maliyetleri: 360p'den 4K'ya saniye başı ücretler, rakiplerle karşılaştırma ve API test sonuçları.